 LiveInspector - AI直播智能巡检平台
# LiveInspector - AI 直播智能巡检平台
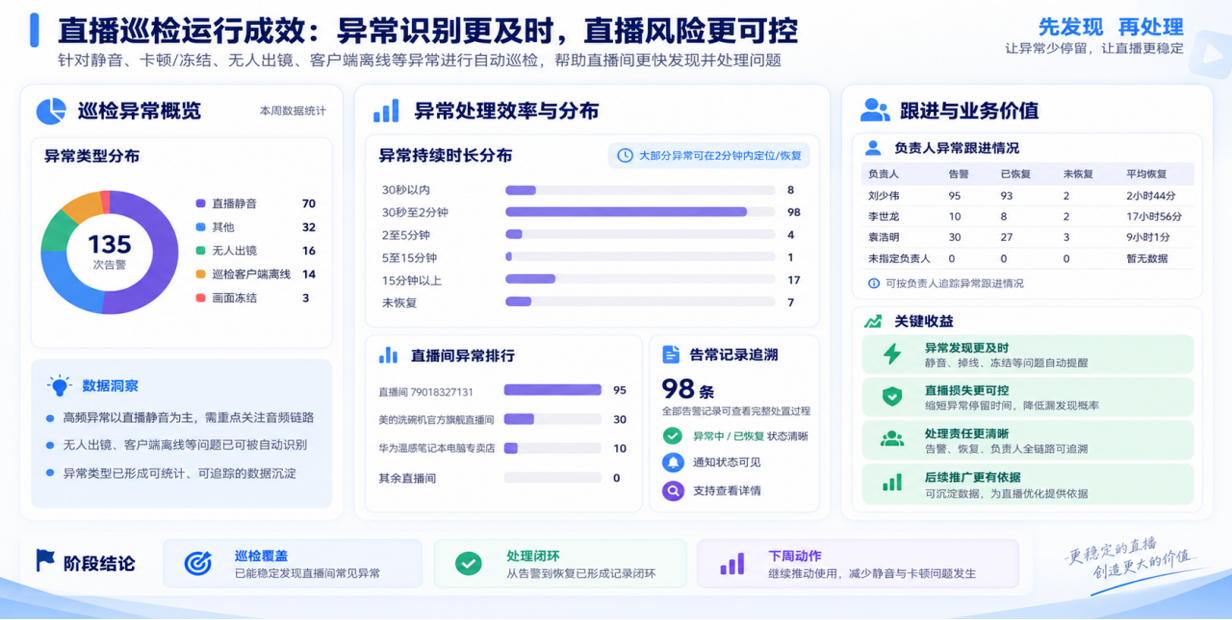
LiveInspector 面向企业直播运营场景,监测主播电脑上的直播运行状态,并将异常检测、本地提醒、服务端上报和责任人通知连接为闭环。它解决的是“人工持续盯场成本高、异常发现滞后、处理过程难追溯”的问题。
当前系统关注主播电脑上的本地运行状态,不等同于观众侧播放质量检测;不能据此断言观众一定不会卡顿或画质异常。
# 使用资料
# 一次异常如何形成闭环
配置直播间与巡检区域
        ↓
客户端采集画面与音频
        ↓
视觉模型 + 规则引擎识别异常
        ↓
本地提醒、事件留痕与证据保存
        ↓
实时上报或离线队列补传
        ↓
服务端关联直播间、通知责任人
        ↓
恢复确认、查询与统计复盘
系统将一次异常视为完整事件,而不是每一帧都重复报警。异常触发、持续、恢复和通知都围绕同一事件实例记录,便于计算持续时间、抑制重复消息和后续复盘。
# 核心能力
| 模块 | 已实现能力 |
|---|---|
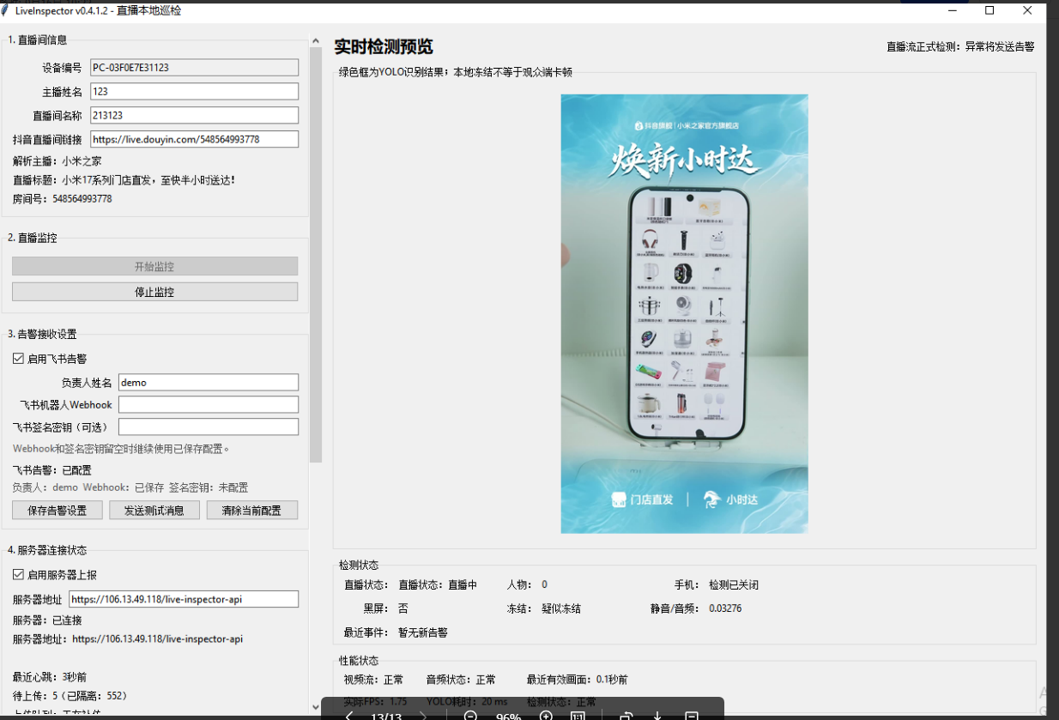
| Windows 客户端 | 选择直播窗口、框选巡检区域、实时显示画面与检测状态、本地提醒与系统托盘运行 |
| 画面与音频检测 | 黑屏、预览冻结、无人、静音、音频输入中断,以及可选的手机检测 |
| 多来源采集 | 本地窗口采集与直播流采集进入统一分析链路;直播流可使用影子模式验证采集与识别,不触发正式告警 |
| 规则引擎 | 持续时长、计数、防抖、冷却、异常触发与恢复生命周期 |
| 服务端闭环 | 设备注册、心跳、事件与截图接收、离线队列补传、存储、通知和查询统计 |
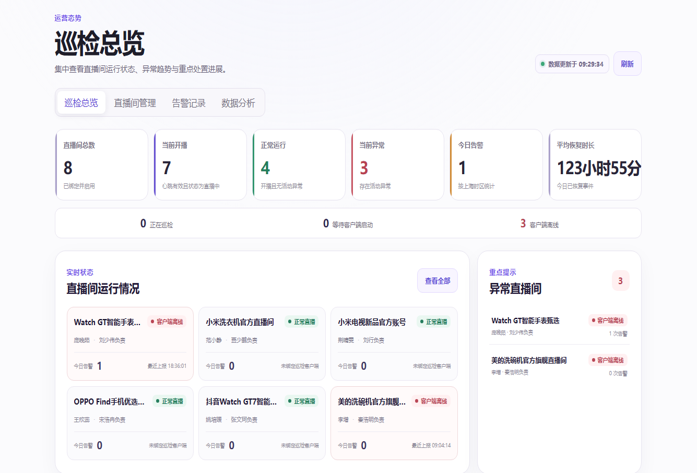
| 直播管理 | 直播间、设备、负责人、告警状态与历史记录的集中管理能力 |
# 避免误报的关键设计
# 未知不等于直播中断
平台状态探测出现失败、风控或接口变化时,系统会进入不确定状态,而不是直接判定掉播。只有直播间状态已确认开播,相关业务异常才会进入累计与告警流程。
# 本地优先,网络恢复后补传
客户端断网时仍可先进行本地提示与事件记录。网络恢复后,通过本地持久化队列补传,避免短暂网络波动造成异常丢失或恢复后误报。
# 统一分析边界
本地窗口与直播流最终接入同一套识别、规则和上报链路,减少两套逻辑分别演进后产生的行为差异。
# 技术架构
Windows 客户端
画面 / 音频采集 + AI 检测 + 规则引擎
        ↓
本地提醒、事件证据、离线队列
        ↓
FastAPI 服务端
设备心跳、事件存储、告警路由、管理查询
        ↓
数据库 / 责任人通知 / Web 管理端
- 客户端:Python、OpenCV、NumPy、MSS、Pillow、YOLO、SoundDevice、FFmpeg。
- 服务端:FastAPI、SQLAlchemy、SQLite、设备通信与事件持久化。
- 管理端:React、Vite、REST API,以及直播流的 HLS 查看能力。
# 当前边界与后续验证
项目已形成客户端、服务端和管理查询的完整闭环。现场网络中断等真实运行环境的验证仍需持续完成,因此当前定位为可进行现场验收的工程版本,而不是对所有直播环境作出稳定性承诺。
最后更新: 9/24/2026, 4:22:53 AM
- 01
- AI 应用前端:把生成结果做成可理解、可确认的交互09-24
- 02
- Docker 实战:让服务从本地可运行走向可交付09-24
- 03
- Linux 服务部署与排障:一份从症状到证据的清单09-24